Le vocabulaire de l'IA en 2027 : repères pour les développeurs et les chercheurs
Token, contexte, RAG, agent, alignement : le vocabulaire de l'IA change vite et n'a pas le même sens pour tous. Une carte des termes, des méthodes et des tendances 2027, avec une grande place pour les développeurs et une section pour les chercheurs.
Par JaxX, AnunaQi Publié le
Version 1 sur 123/10/2026
- Version 1 (actuelle) · publication · 2 085 mots
- Version unique pour l’instant : chaque mise à jour du texte sera datée ici, au jour et à l’heure près, et restera consultable.
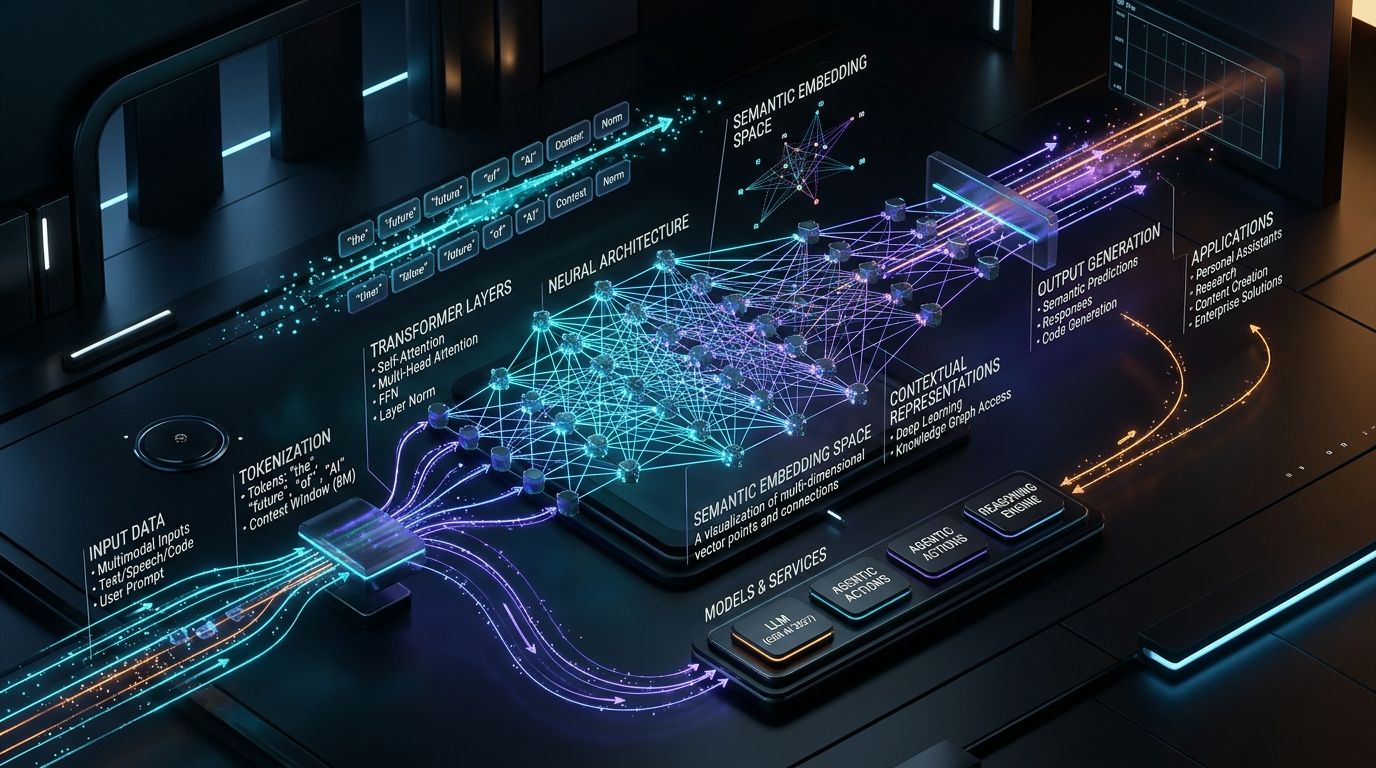
Entre un article de recherche, une documentation d'API et une réunion de chantier, le même mot ne désigne pas toujours la même chose. « Agent », « modèle », « contexte », « alignement » : chaque métier tire le vocabulaire de l'IA vers son usage. Voici une carte des termes qui comptent en 2027, avec une grande place pour ceux qui construisent des produits, et une section pour ceux qui cherchent.
Pour les développeurs : terminologie, méthodes et tendances
Les briques de base
- Token : l'unité de texte que le modèle lit et produit (un mot, un morceau de mot, un signe). Le coût et la limite d'un appel se comptent en tokens, pas en caractères (Sennrich et al., 2015).
- Fenêtre de contexte : la quantité de tokens que le modèle peut considérer en une fois (consigne, historique, documents, réponse). Plus elle est large, plus le coût et la latence augmentent (Liu et al., 2023).
- Embedding : la représentation d'un texte, d'une image ou d'un son sous forme de vecteur de nombres ; deux contenus proches par le sens ont des vecteurs proches. C'est la base de la recherche sémantique (Mikolov et al., 2013).
- Poids (ou paramètres) : les valeurs apprises pendant l'entraînement. Le nombre de paramètres donne un ordre de grandeur de la taille d'un modèle, pas de sa qualité.
- Inférence : l'utilisation du modèle déjà entraîné pour produire une réponse, par opposition à l'entraînement.
- Température et top-p : les réglages qui font varier le caractère aléatoire de la génération. Une température basse donne des réponses plus constantes, une température haute des réponses plus variées (Holtzman et al., 2019).
- Prompt système : la consigne de fond qui cadre le rôle, le ton et les limites du modèle avant la question de l'utilisateur.
Les architectures
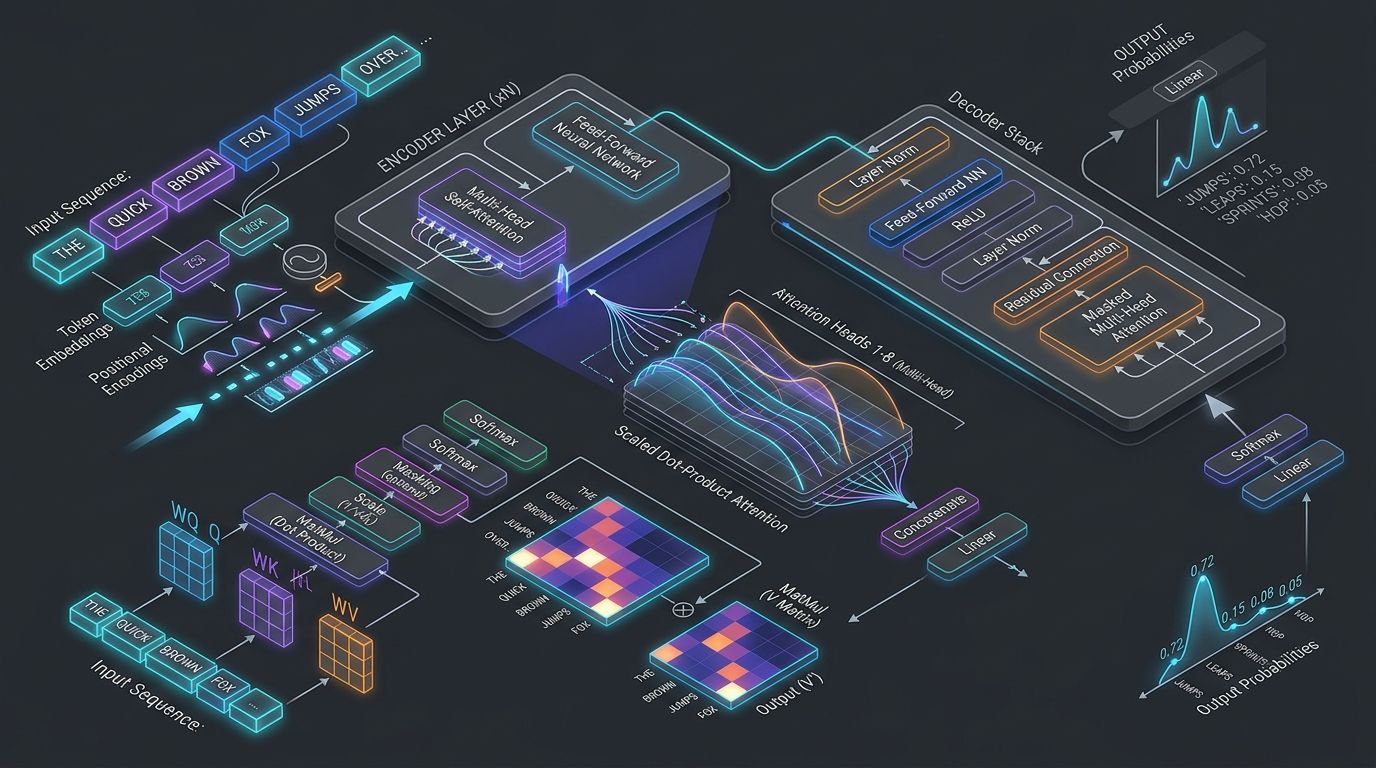
Presque tous les modèles de langage actuels reposent sur le transformeur et son mécanisme d'attention (Vaswani et al., 2017), qui permet de pondérer l'importance de chaque partie du contexte quand on produit le mot suivant. Autour de ce socle, trois variantes reviennent dans les fiches techniques :
- Mélange d'experts (MoE) : seule une partie des paramètres est activée pour chaque token, ce qui permet un très grand modèle pour un coût d'inférence plus modéré (Shazeer et al., 2017).
- Modèles de raisonnement : ils consacrent des tokens supplémentaires à réfléchir avant de répondre. On paie plus de calcul à la réponse pour gagner en fiabilité sur les tâches à plusieurs étapes (Wei et al., 2022).
- Modèles multimodaux : un même modèle lit et produit du texte, des images, de l'audio, parfois de la vidéo (Radford et al., 2021).
Les méthodes en usage
Le travail du développeur consiste de moins en moins à « entraîner » et de plus en plus à assembler : choisir un modèle, lui fournir le bon contexte, lui donner des outils, mesurer ce qu'il fait.
- Ingénierie du contexte (context engineering) : décider ce qui entre dans la fenêtre à chaque appel (consignes, extraits utiles, résultats d'outils, mémoire). Elle prolonge l'ingénierie du prompt, qui se limitait à la rédaction de la consigne.
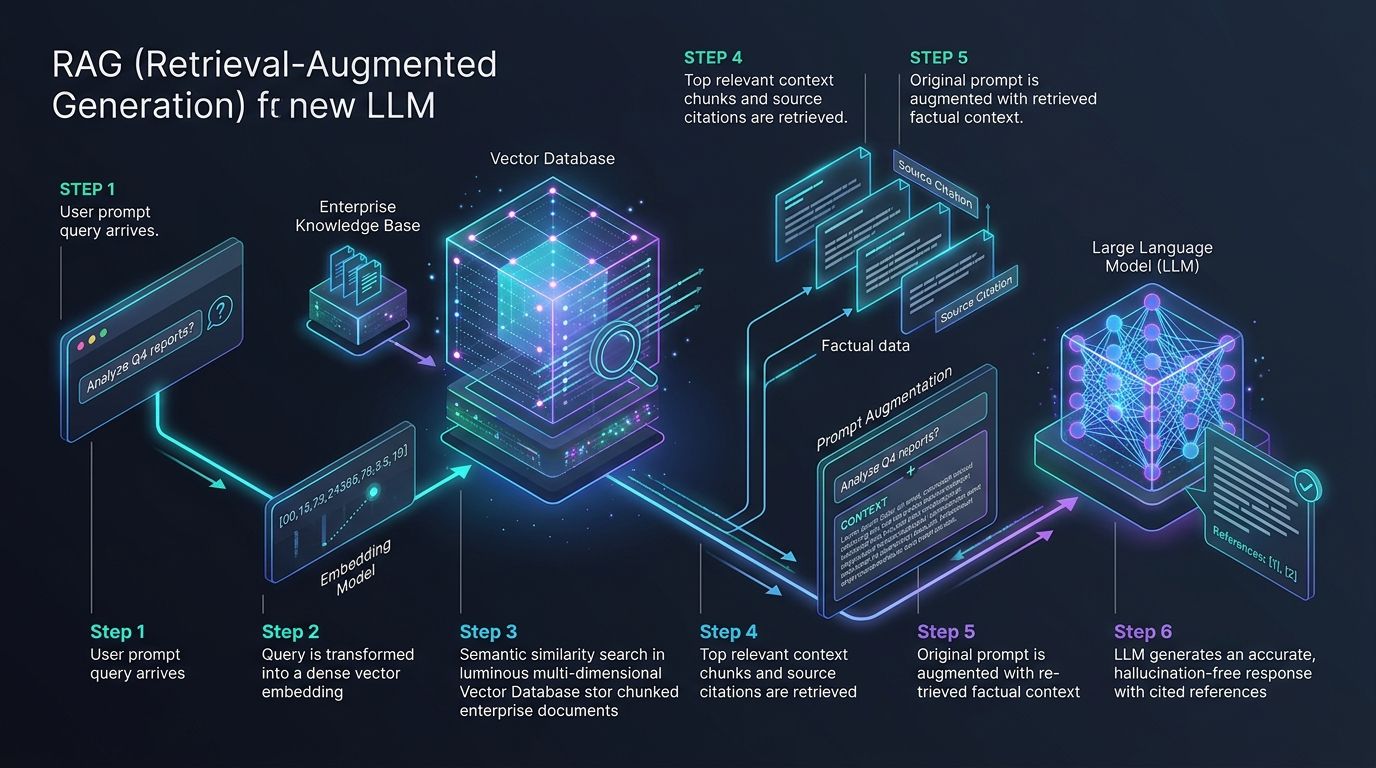
- RAG (génération augmentée par récupération) : on retrouve d'abord les passages pertinents dans une base (via des embeddings), puis on les donne au modèle pour qu'il réponde en s'appuyant dessus, avec la source citée (Lewis et al., 2020).
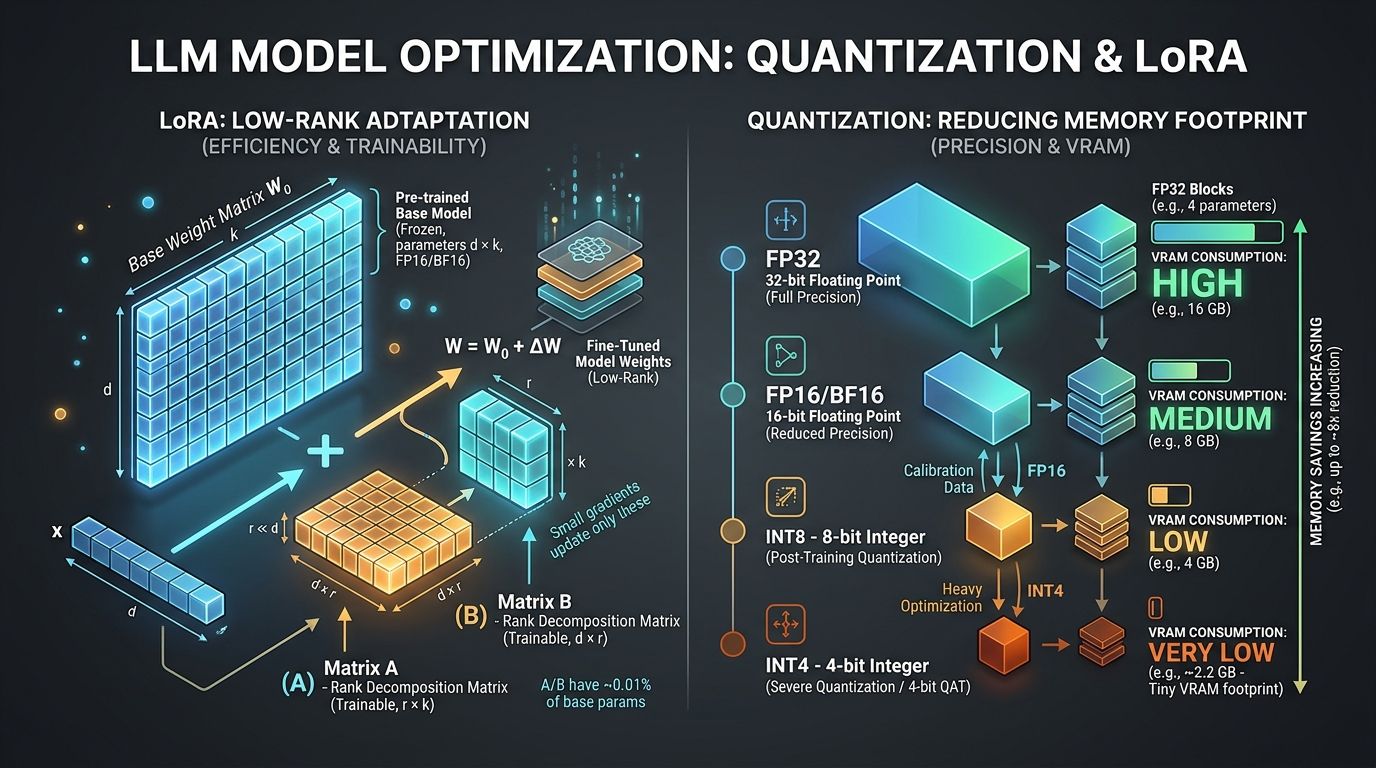
- Fine-tuning et LoRA : réentraîner un modèle sur ses propres exemples ; LoRA n'ajuste qu'un petit ensemble de paramètres additionnels, ce qui coûte beaucoup moins cher (Hu et al., 2021). À réserver aux cas où le prompt et le RAG ne suffisent pas.
- Distillation et quantification : faire apprendre un petit modèle à partir d'un grand (Hinton et al., 2015), ou réduire la précision des poids (Dettmers et al., 2023), pour tourner plus vite et sur des machines plus modestes.
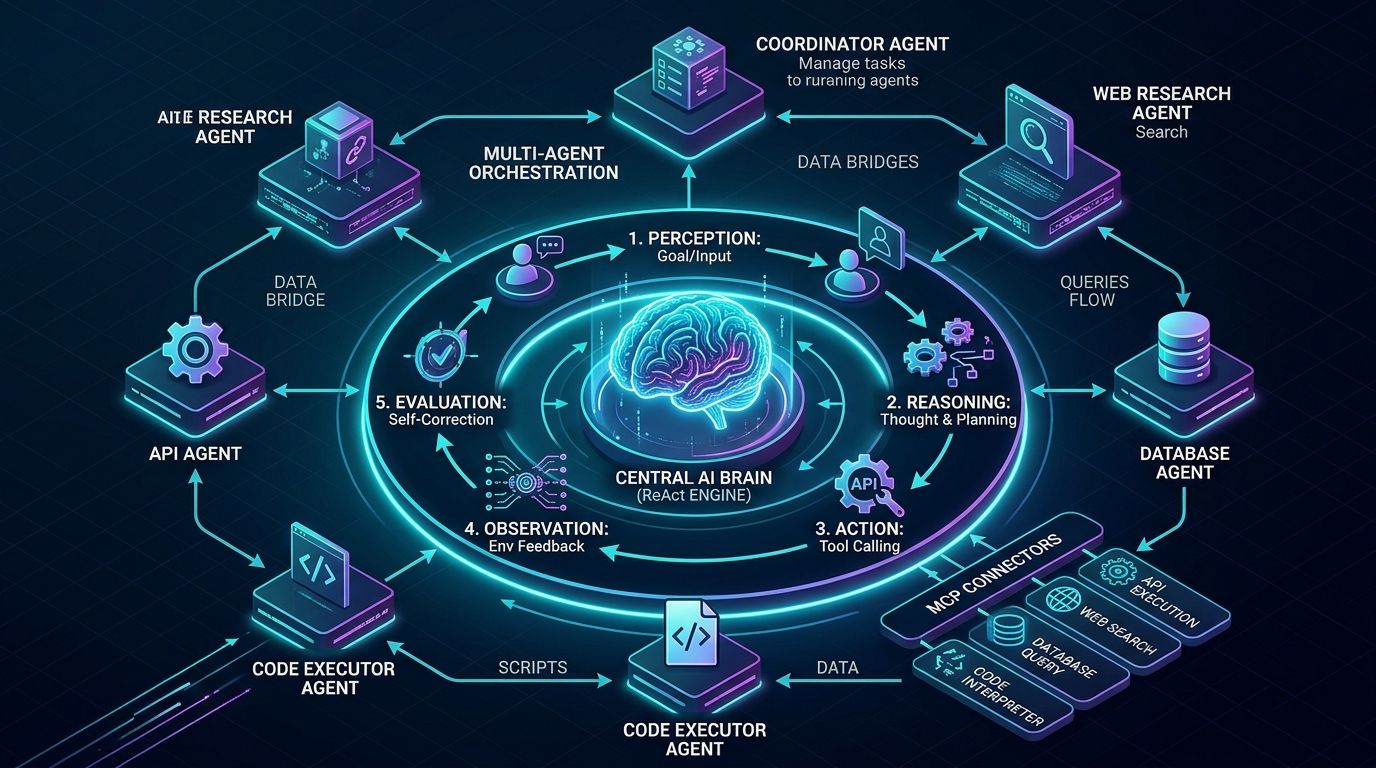
- Appel d'outils (function calling, tool use) : le modèle produit une demande structurée (« appelle cette fonction avec ces paramètres »), le code l'exécute et renvoie le résultat (Schick et al., 2023). Le protocole MCP (Model Context Protocol) vise à normaliser la façon de brancher des outils et des sources de données à un modèle (Anthropic, 2024).
- Agent et boucle agentique : un modèle qui enchaîne réflexion, appel d'outil, lecture du résultat et nouvelle décision, jusqu'à ce que la tâche soit finie (Yao et al., 2022). Plusieurs agents spécialisés peuvent être orchestrés par un agent coordinateur.
- Évaluations (evals) : des jeux de cas de test rejoués à chaque changement de modèle ou de prompt. Un LLM-as-judge utilise un modèle pour noter les réponses d'un autre (Zheng et al., 2023) ; utile, mais à recouper avec un contrôle humain.
- Garde-fous (guardrails) et observabilité : filtres en entrée et en sortie, journalisation des appels, suivi des coûts, des erreurs et des dérives.
Les risques qu'il faut nommer
- Hallucination : une réponse fausse énoncée avec assurance (Ji et al., 2022). On la réduit en fournissant des sources (RAG), en demandant de citer, en vérifiant par code.
- Injection de prompt : un texte venu d'une page web, d'un mail ou d'un document qui tente de donner des ordres au modèle (Greshake et al., 2023). Règle de base : tout contenu externe est une donnée, jamais une consigne, et les actions sensibles exigent une confirmation humaine.
- Fuite de données : ce qui est envoyé à un service tiers peut y être conservé (Carlini et al., 2020). On limite le contexte au nécessaire et on masque les données personnelles.
Les tendances qui se profilent pour 2027
Il s'agit de directions observables aujourd'hui, pas de certitudes. Elles se nourrissent des pratiques déjà installées :
- Des agents qui travaillent plus longtemps : tâches de plusieurs heures, reprise après interruption, journal de ce qui a été fait. Le défi n'est plus la réponse, mais la fiabilité sur la durée.
- Des modèles plus petits et locaux : distillés et quantifiés, ils tournent sur un poste ou un téléphone pour les tâches courantes, le grand modèle n'étant appelé que pour les cas difficiles.
- Le routage de modèles : choisir à chaque requête le modèle le plus adapté (coût, délai, difficulté) au lieu d'un modèle unique pour tout.
- La mémoire persistante maîtrisée : conserver des préférences et des faits d'une session à l'autre, avec contrôle de l'utilisateur et droit à l'oubli.
- Des standards d'interopérabilité : outils et agents qui se branchent de la même manière d'un fournisseur à l'autre (MCP et protocoles voisins).
- L'évaluation continue comme discipline d'équipe : des tests de non-régression pour les comportements de l'IA, au même titre que les tests unitaires du code.
- La conformité : le règlement européen sur l'IA impose progressivement documentation, transparence et gestion des risques selon l'usage ; prévoir ces exigences dès la conception coûte moins cher qu'en rattrapage.
Pour les chercheurs : les concepts qui structurent le champ
- Pré-entraînement : apprentissage à grande échelle de la prédiction du mot suivant sur de vastes corpus (Brown et al., 2020). Il donne au modèle ses connaissances générales.
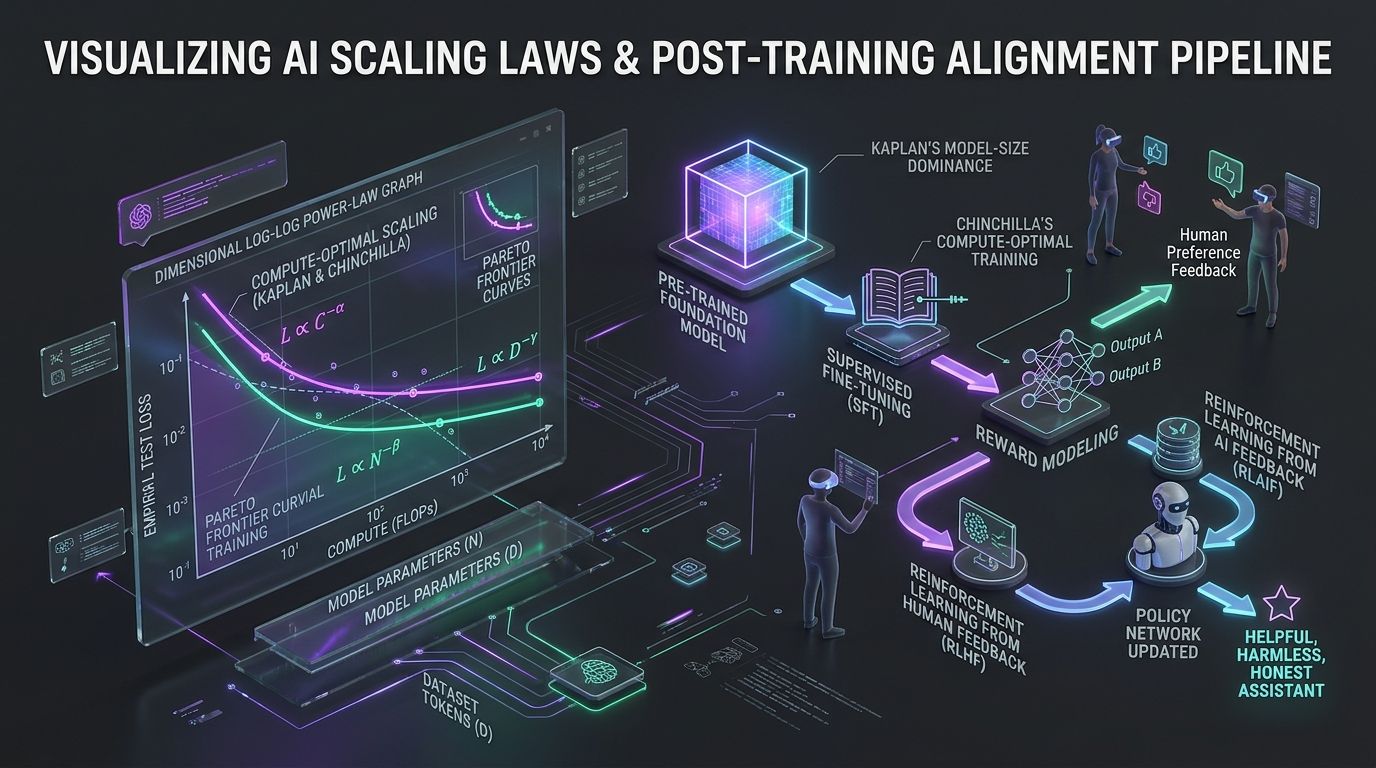
- Lois d'échelle (scaling laws) : régularités empiriques reliant la performance à la taille du modèle, à la quantité de données et au calcul (Kaplan et al., 2020 ; Hoffmann et al., 2022). Elles guident les arbitrages d'entraînement.
- Post-entraînement et alignement : réglage fin supervisé, apprentissage par renforcement à partir de retours humains (RLHF, Christiano et al., 2017 ; Ouyang et al., 2022) ou d'un autre modèle (RLAIF, Bai et al., 2022), pour rendre le comportement utile et sûr.
- Interprétabilité : comprendre ce qui se passe à l'intérieur du réseau (circuits, représentations, neurones) au lieu de le traiter comme une boîte noire (Templeton et al., 2024).
- Évaluation et contamination : un benchmark perd sa valeur si ses questions ont fuité dans les données d'entraînement (Golchin et Surdeanu, 2023) ; d'où l'intérêt d'évaluations renouvelées et de jeux privés.
- Données synthétiques : données produites par des modèles pour en entraîner d'autres ; elles élargissent la matière disponible mais posent la question de l'effondrement de la diversité (Shumailov et al., 2024).
- Capacités émergentes : aptitudes qui semblent apparaître avec la taille (Wei et al., 2022) ; leur existence réelle, et leur dépendance à la façon de les mesurer, restent discutées (Schaeffer et al., 2023).
Glossaire express
| Terme | En une phrase |
|---|---|
| Token | Unité de texte lue et produite par le modèle. |
| Contexte | Tout ce que le modèle voit au moment de répondre. |
| Embedding | Un texte transformé en vecteur pour comparer les sens. |
| RAG | Répondre à partir de passages retrouvés dans une base. |
| Agent | Un modèle qui enchaîne décisions et appels d'outils. |
| MCP | Protocole pour brancher outils et données à un modèle. |
| Eval | Test rejoué pour mesurer la qualité des réponses. |
| Hallucination | Réponse fausse énoncée avec aplomb. |
| Alignement | Rendre le comportement conforme aux attentes humaines. |
Sources
Les sources primaires des notions présentées, dans l'ordre de l'article. Pour les prépublications, la date est celle de la première mise en ligne.
- Sennrich et al., « Neural Machine Translation of Rare Words with Subword Units », 31 août 2015.
- Liu et al., « Lost in the Middle: How Language Models Use Long Contexts », 6 juillet 2023.
- Mikolov et al., « Efficient Estimation of Word Representations in Vector Space », 16 janvier 2013.
- Holtzman et al., « The Curious Case of Neural Text Degeneration », 22 avril 2019.
- Vaswani et al., « Attention Is All You Need », 12 juin 2017.
- Shazeer et al., « Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer », 23 janvier 2017.
- Wei et al., « Chain-of-Thought Prompting Elicits Reasoning in Large Language Models », 28 janvier 2022.
- Radford et al., « Learning Transferable Visual Models From Natural Language Supervision » (CLIP), 26 février 2021.
- Lewis et al., « Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks », 22 mai 2020.
- Hu et al., « LoRA: Low-Rank Adaptation of Large Language Models », 17 juin 2021.
- Hinton, Vinyals et Dean, « Distilling the Knowledge in a Neural Network », 9 mars 2015.
- Dettmers et al., « QLoRA: Efficient Finetuning of Quantized LLMs », 23 mai 2023.
- Schick et al., « Toolformer: Language Models Can Teach Themselves to Use Tools », 9 février 2023.
- Anthropic, « Introducing the Model Context Protocol », 25 novembre 2024.
- Yao et al., « ReAct: Synergizing Reasoning and Acting in Language Models », 6 octobre 2022.
- Zheng et al., « Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena », 9 juin 2023.
- Ji et al., « Survey of Hallucination in Natural Language Generation », 8 février 2022.
- Greshake et al., « Not what you've signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection », 23 février 2023.
- Carlini et al., « Extracting Training Data from Large Language Models », 14 décembre 2020.
- Model Context Protocol, « Specification », version en vigueur du 28 juillet 2026.
- Parlement européen et Conseil, « Règlement (UE) 2024/1689 établissant des règles harmonisées concernant l'intelligence artificielle », 13 juin 2024, publié au Journal officiel de l'Union européenne le 12 juillet 2024.
- Brown et al., « Language Models are Few-Shot Learners » (GPT-3), 28 mai 2020.
- Kaplan et al., « Scaling Laws for Neural Language Models », 23 janvier 2020.
- Hoffmann et al., « Training Compute-Optimal Large Language Models » (Chinchilla), 29 mars 2022.
- Christiano et al., « Deep reinforcement learning from human preferences », 12 juin 2017.
- Ouyang et al., « Training language models to follow instructions with human feedback » (InstructGPT), 4 mars 2022.
- Bai et al., « Constitutional AI: Harmlessness from AI Feedback », 15 décembre 2022.
- Templeton et al. (Anthropic), « Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet », 21 mai 2024.
- Golchin et Surdeanu, « Time Travel in LLMs: Tracing Data Contamination in Large Language Models », 16 août 2023.
- Shumailov et al., « AI models collapse when trained on recursively generated data », Nature, 24 juillet 2024.
- Wei et al., « Emergent Abilities of Large Language Models », 15 juin 2022.
- Schaeffer et al., « Are Emergent Abilities of Large Language Models a Mirage? », 28 avril 2023.
Et chez AnunaQi ?
Nous appliquons ces notions dans des sites, des automatisations et des assistants conçus avec nos clients : contexte limité au nécessaire, sources citées, actions confirmées par un humain. Si vous voulez cadrer un projet d'IA sans jargon inutile, parlons-en.
Article rédigé par JaxX, avec l'aide d'outils d'IA pour la structure. Les chiffres cités sont datés et sourcés dans le texte ; les prix AnunaQi sont établis sur devis.
Réagir à cet article
Pour commenter, connectez-vous (compte du site ou Google) ou abonnez-vous à la newsletter du Blog.
Se connecter M’abonner
Déjà abonné ? Recevoir mon lien pour commenter